Cómo organizan las empresas sus datos
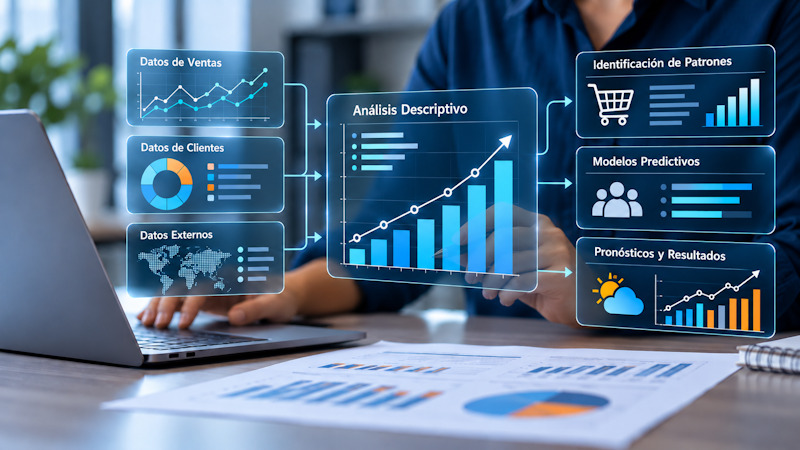
Antes de aplicar técnicas de análisis, las empresas necesitan organizar y consolidar los datos que generan en sus operaciones y recopilan de distintas fuentes.
El rol de las bases de datos y la estructuración de la información
Las bases de datos relacionales permiten recopilar, estructurar y consultar registros cotidianos de la empresa, como transacciones de ventas, niveles de inventario o registros de horarios, según el artículo “What is data integration?” (2024), de Google Cloud.
Por ejemplo, en una cadena de supermercados, cada compra registrada en caja actualiza automáticamente el stock disponible de productos perecederos.
Volumen y diversidad de datos en big data
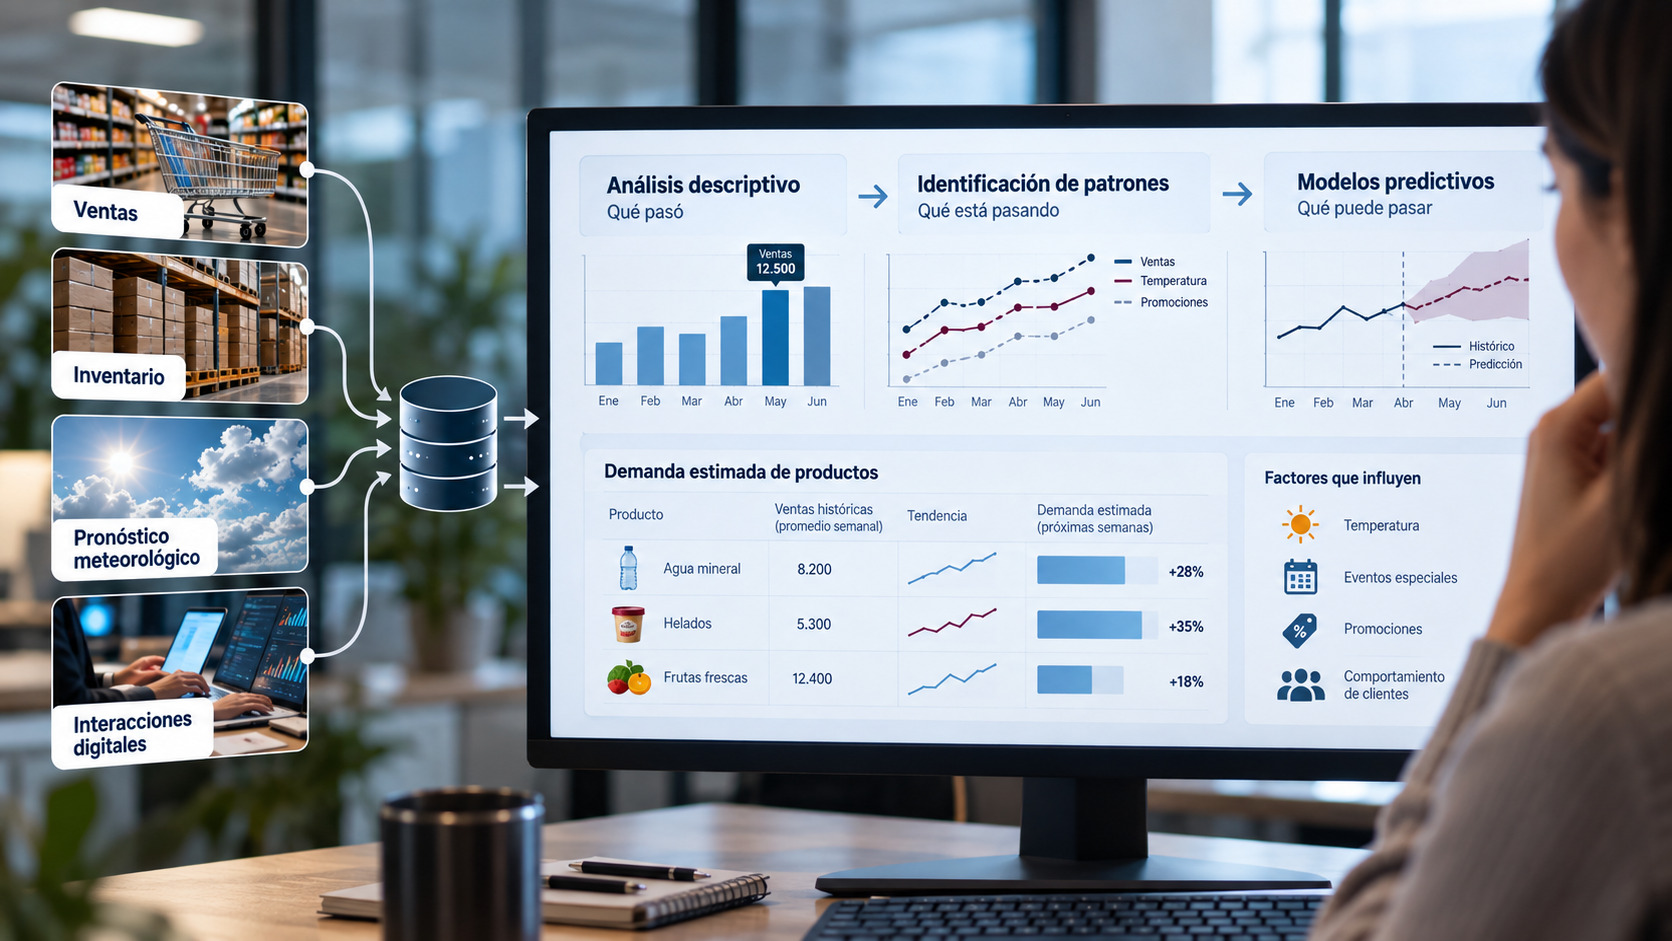
Cuando las empresas incorporan grandes volúmenes de datos provenientes de fuentes diversas y generados a gran velocidad, surge el desafío de gestionar esa información a gran escala.
Según IBM en el artículo “What is big data?” (2024), este concepto no se limita a la acumulación de grandes volúmenes de información, sino que se caracteriza por la convergencia de variedad, velocidad y complejidad en los flujos de datos.
Frente a esa complejidad, la ciencia de datos utiliza métodos estadísticos, computacionales y de análisis para extraer información útil de esos datos.
Cómo la ciencia de datos convierte datos en conocimiento para decidir
Tener datos organizados no es suficiente: la ciencia de datos aplica métodos de análisis para identificar patrones, explicar comportamientos y generar modelos que ayuden a anticipar escenarios.
Del análisis descriptivo a la predicción: cómo los datos ayudan a anticipar escenarios
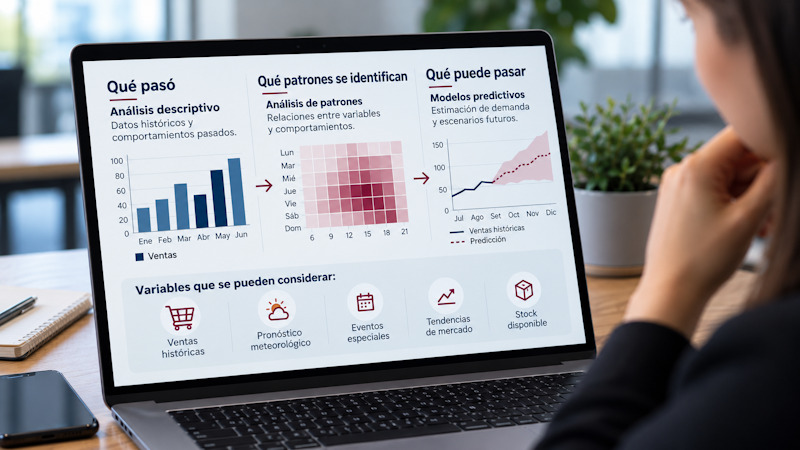
El análisis dentro de una organización suele comenzar por comprender qué ha sucedido.
A partir de los datos, el análisis puede avanzar desde la descripción de lo ocurrido hacia la identificación de patrones y la predicción de escenarios.
Como se explica en el artículo “What is predictive analytics?” (2024), de Google Cloud, mediante el análisis descriptivo las empresas evalúan comportamientos e indicadores históricos.
Luego, al incorporar algoritmos de aprendizaje automático y modelos estadísticos, las empresas construyen modelos predictivos que permiten proyectar tendencias de mercado, estimar la demanda de productos o detectar riesgos operativos antes de que se concreten.
En el caso de la cadena de supermercados, el análisis descriptivo permite constatar, por ejemplo, qué días aumentó la venta de determinados productos. Los modelos predictivos combinan esa información con otras variables, como los pronósticos meteorológicos, para anticipar cuánta mercadería se demandará en un período determinado.
¿Te interesa la ciencia de datos?
Conocé la Licenciatura en Sistemas
De los modelos a la toma de decisiones: convertir resultados en acciones
Una predicción solo genera valor cuando ayuda a tomar una decisión. El paso decisivo es traducir esas estimaciones cuantitativas en medidas organizacionales concretas.
Siguiendo el caso del supermercado, si los datos meteorológicos y el historial de ventas indican una posible ola de calor, el modelo puede estimar un aumento de la demanda. Así, la empresa puede ajustar las órdenes de compra a proveedores y reorganizar la logística de distribución para asegurar el stock en góndola.
Cuando los modelos identifican variaciones en el consumo o ineficiencias en los procesos, aportan evidencia objetiva para que los equipos directivos evalúen distintas alternativas y asignen recursos con mayor precisión.
La analítica avanzada no busca reemplazar el criterio ni la experiencia humana, sino potenciarlos. Para ello, ofrece un marco riguroso que ayuda a reducir sesgos intuitivos y a fundamentar las decisiones en evidencia.
De la predicción a la automatización: ciencia de datos e inteligencia artificial
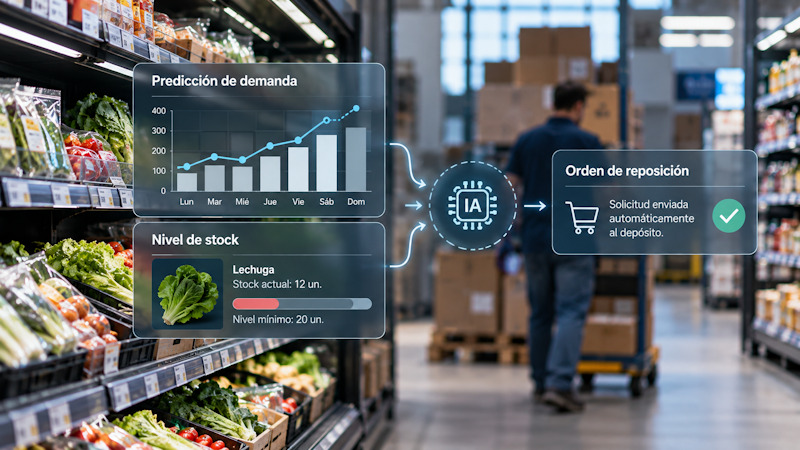
Cuando los modelos de aprendizaje automático se integran con sistemas operativos, las organizaciones pueden automatizar decisiones recurrentes y liberar capacidad para tareas de mayor valor estratégico.
Decisiones operativas automatizadas con machine learning
El aprendizaje automático es un conjunto de métodos que permite a los sistemas identificar patrones a partir de datos y mejorar su desempeño en determinadas tareas sin programar explícitamente cada regla.
Tal como se explica en el artículo “Data science vs. machine learning: what's the difference?” (2024), de IBM, estos modelos pueden entrenarse con datos históricos para identificar patrones recurrentes y ejecutar acciones automáticas sin intervención humana directa.
En el contexto minorista, esto permite que el sistema emita automáticamente las solicitudes de reposición a los depósitos cuando el stock de productos perecederos alcanza un nivel mínimo establecido.
Calidad y uso responsable de los datos
Sin embargo, la automatización no está exenta de riesgos. Como los algoritmos aprenden de los datos con los que se entrenan, la presencia de información errónea o sesgada puede producir decisiones automatizadas deficientes.
Si el supermercado registra de manera imprecisa las mermas, el modelo puede calcular incorrectamente las necesidades de stock y generar pedidos inadecuados.
Por eso, la calidad, la gobernanza y el uso responsable de los datos forman parte del proceso de análisis y no constituyen una etapa posterior o aislada.
La ciencia de datos transforma datos organizados en evidencia para analizar situaciones, anticipar escenarios y fundamentar decisiones.
Su valor depende de la calidad de los datos, una interpretación adecuada y el criterio humano.
¿Te interesa la ciencia de datos?
Conocé la Licenciatura en Sistemas